Reflection团队自从一年多前宣布启动以来,始终保持低调,专注于代码生成和强化学习方法的研发。尽管外界对其能否推出实际模型持怀疑态度,但他们终于发布了Beam模型,这是一款5010亿参数总量、230亿活跃参数的MoE模型,专注于代码、智能代理和科学计算任务。
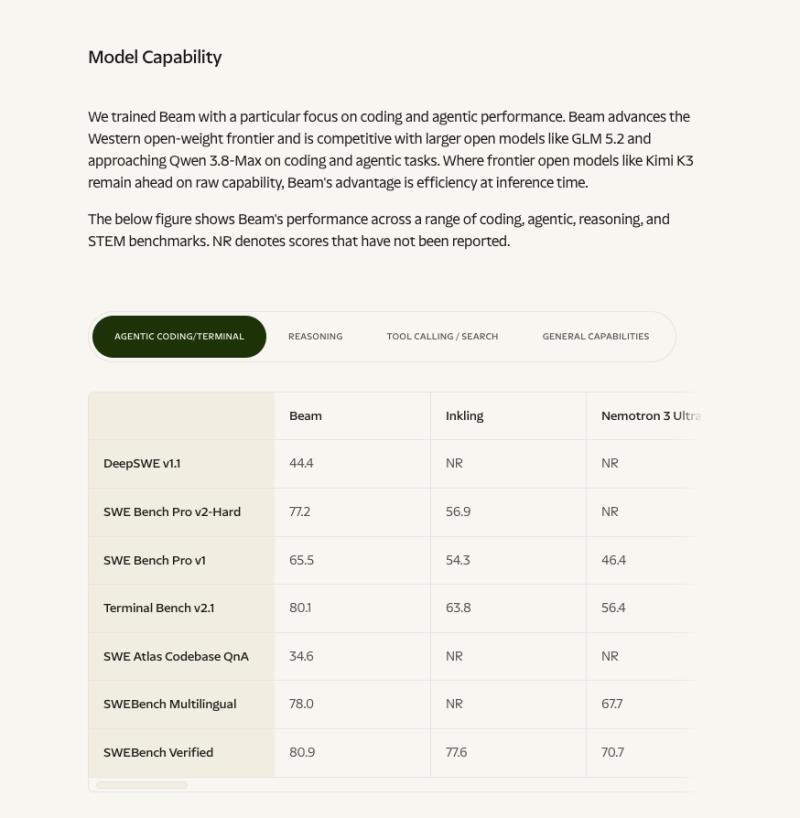
Beam模型与Inkling、Nemotron和GLM 5.2等模型相比较,虽然在某些指标上落后于最新的GLM 5.3、Kimi K3、Qwen 3.8 Max和DeepSeek V4.1 Flash,但作为完全从零开始在美国训练的模型,Beam为市场带来了更多选择,也标志着Reflection作为一个功能完善的新实验室正式亮相。
团队透露,Beam的预训练使用了23800亿个token,部分数据来自数亿份PDF的OCR处理,强化学习阶段在约1万块GB300 GPU上进行了超过1亿次的任务执行。模型在SWE-bench Verified测试中取得80.9分,推理效率是GLM 5.2的3至4倍,预训练和强化学习各耗时约四周。完整权重将在本月以Apache 2.0协议开源。
此外,市场上还有其他开源和专业模型发布,如Aleph Alpha的Kolibri(780亿参数)、Reka的Rho-1(190亿参数,支持多模态)、Command Code的决策模型Agr系列,以及Upstage和Eleven Labs的轻量级模型。
在AI订阅服务方面,Anthropic的Claude订阅被评估为API价值是OpenAI的五倍以上,尽管调整任务成本后优势有所缩小。OpenAI近期调整了容量和使用限制,提升了GPT-6系列模型的响应速度。
开发者工具方面,Hugging Face推出了多环境强化学习代理工具,支持多种格式和精确的token追踪。Earendil发布了支持持久化的多任务工作流引擎Pi Durable。Cognition开源了基于git和markdown的代理记忆库。Cursor SDK更新支持运行时引导和自定义工具注解。
在模型训练和推理技术上,NVIDIA和Google提出了基于验证的采样方法提升模型准确率。UT Austin的研究表明上下文压缩对速度和性能有复杂影响。Dust提出了一种激活扰动的零阶优化方法,显著提升计算效率。硬件方面,阿里巴巴发布了新一代大内存加速器,预计2027年初上市。
安全与政策领域,OpenAI将在欧盟范围内为ChatGPT和Codex文本添加隐形水印以符合AI法规,且仅授权研究人员使用检测工具。业界专家呼吁建立独立的安全标准和多层次系统安全机制。前OpenAI研究员呼吁禁止某些自主武器,支持国际监管机构的建立。
总体来看,Reflection Beam的发布不仅丰富了美国本土的开源模型生态,也推动了AI技术在代码生成、科学计算和代理系统等领域的发展。未来几个月,随着更多模型和工具的推出,开源AI生态将更加活跃和多元。