日本Reflection AI公司宣布启动其首款开放权重模型“Beam”的早期访问。相关的权重数据、技术报告、模型卡以及开发者资料预计将在本月内陆续公开。
“Beam”模型拥有总参数量达5010亿个,其中活跃参数为230亿个,专为编码、推理和智能代理处理工作负载设计。该模型通过使用来自网络及公司自有许可数据集的23.8万亿个多样且高质量的标记进行预训练,达到了与同规模现有开放基础模型相当甚至更优的性能水平。
为了支持大规模高计算强化学习(RL),Reflection AI还开发了相应的算法、训练环境和基础设施。在4周的训练周期内,利用10500台NVIDIA GB300 GPU,完成了超过1亿次的强化学习回合。
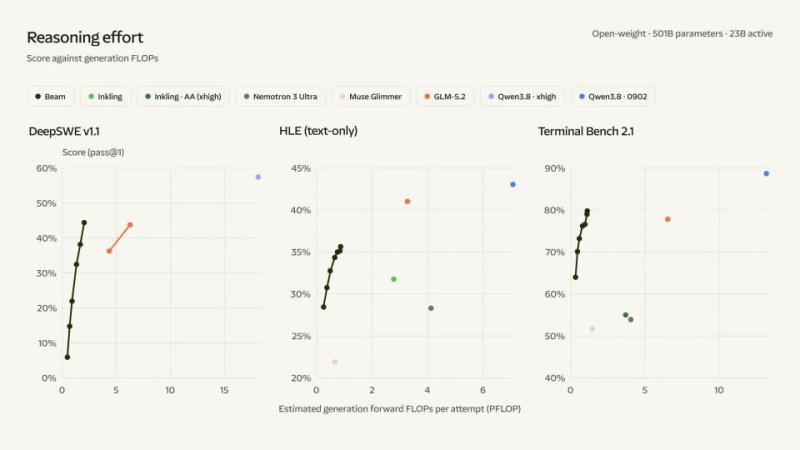
功能上,Beam重点优化了编码和智能代理性能。在性能表现上,它能够与大型开放模型如GLM-5.2竞争,并在编码和代理任务中接近Qwen 3.8-Max的水平。Beam的突出优势在于推理效率,结合高效的推理能力,显著提升了编码和代理功能的表现。在高级推理基准测试中,Beam取得了与GLM-5.2相当的成绩,但推理计算量仅为其三分之一到四分之一。与拥有2万亿以上参数的Qwen 3.8-Max系列模型相比,Beam在效率提升方面更为显著,提升了每个标记的智能水平,实现了低成本且强大的模型功能。