日本Preferred Networks公司于11月9日宣布,基于国产生成式AI基础模型「PLaMo」,开发了专门针对金融机构实际应用的小型语言模型(SLM)「PLaMo 3.0 Fin」,并作为开源权重模型在该公司维护的Hugging Face页面公开。该模型满足金融行业严格的安全要求,支持在云端闭域环境和本地(on-premises)环境中部署。
此外,PLaMo 3.0 Fin的后续训练中,针对推理(Reasoning)功能和工具调用的指令跟随学习,采用了Preferred Networks自主研发的AI半导体「MN-Core 2」进行加速。
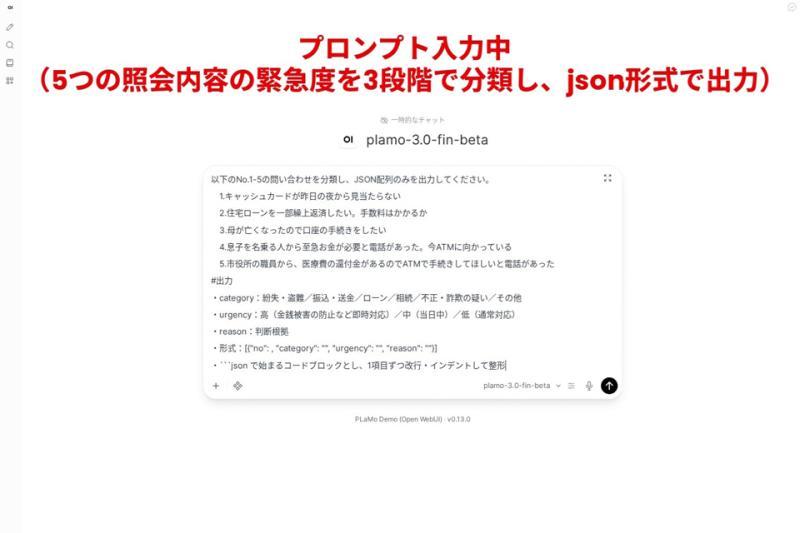
PLaMo 3.0 Fin的主要特点
- 以日本国立研究开发法人信息通信研究机构(NICT)联合研究成果的预训练模型「PLaMo 3 NICT」为基础,Preferred Networks利用以日本为中心的金融领域数据进行额外训练,强化金融知识。
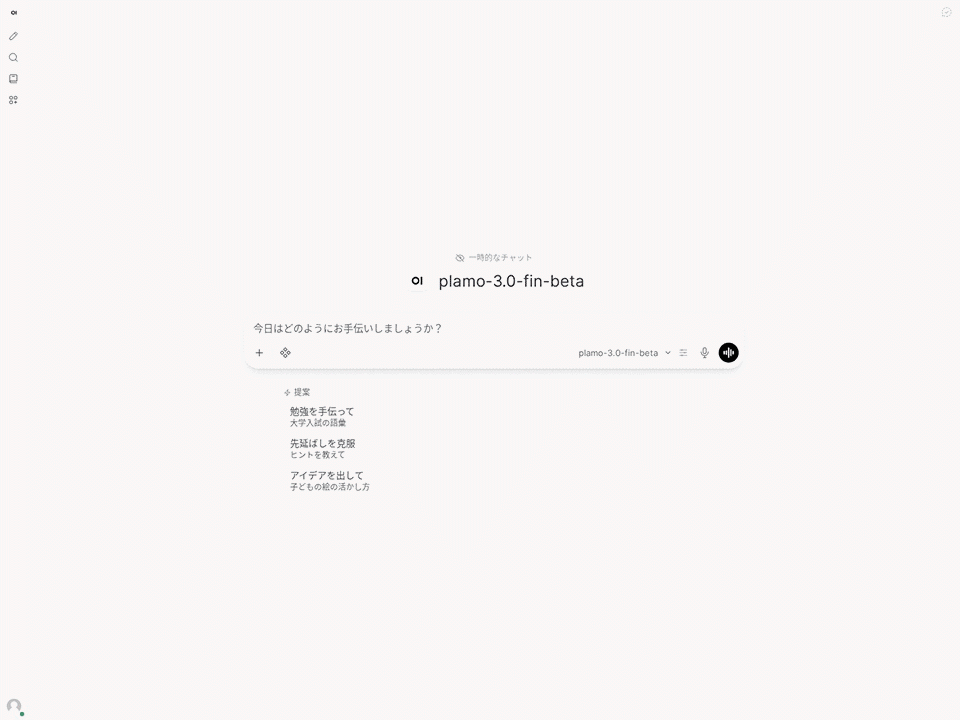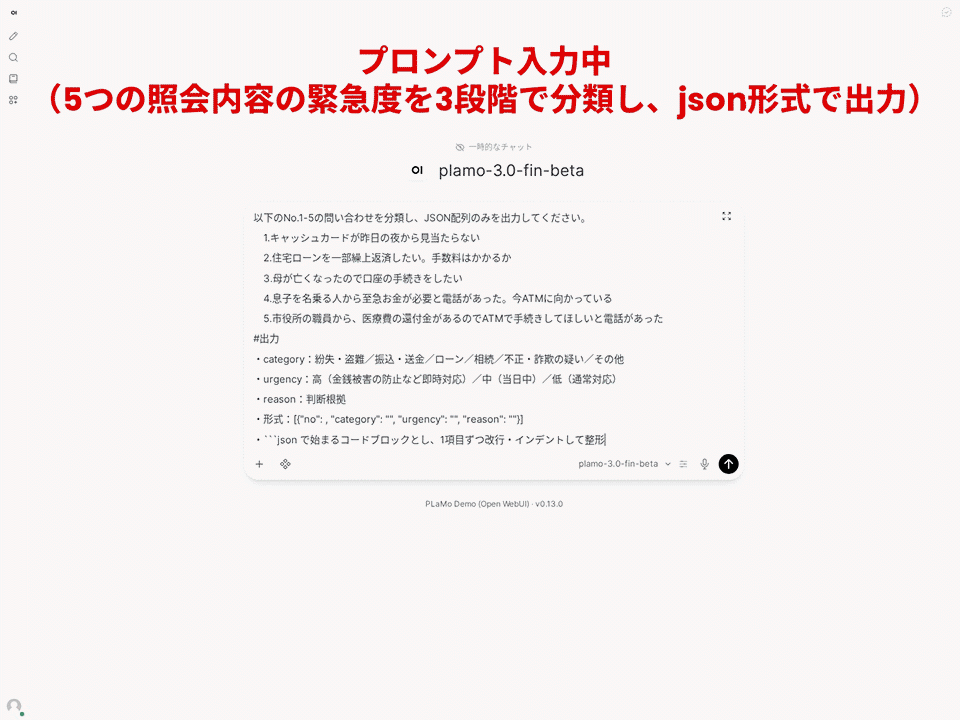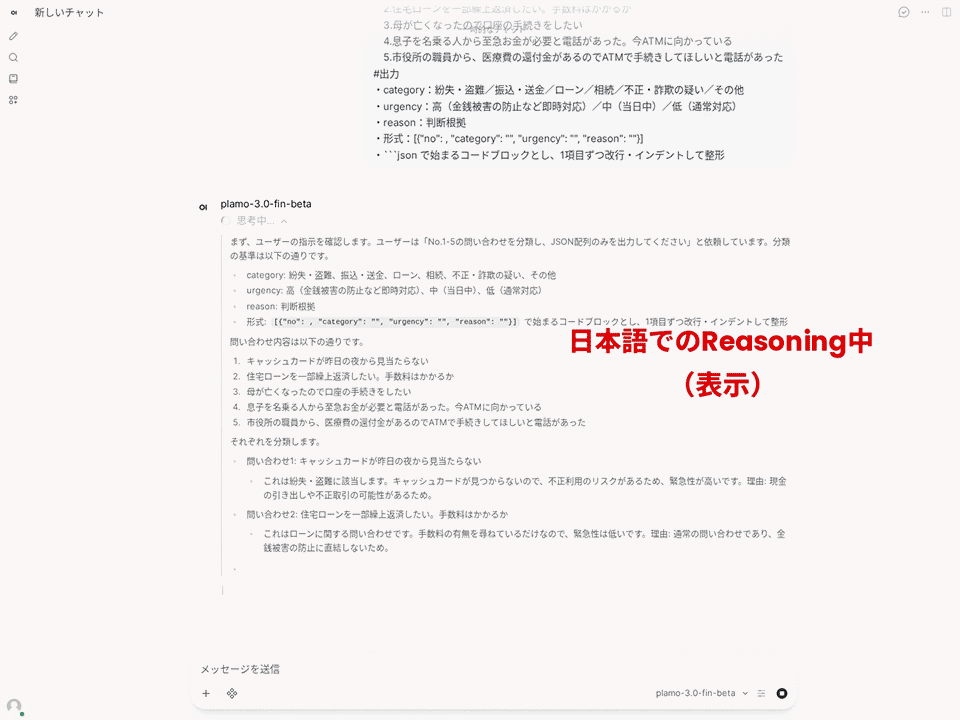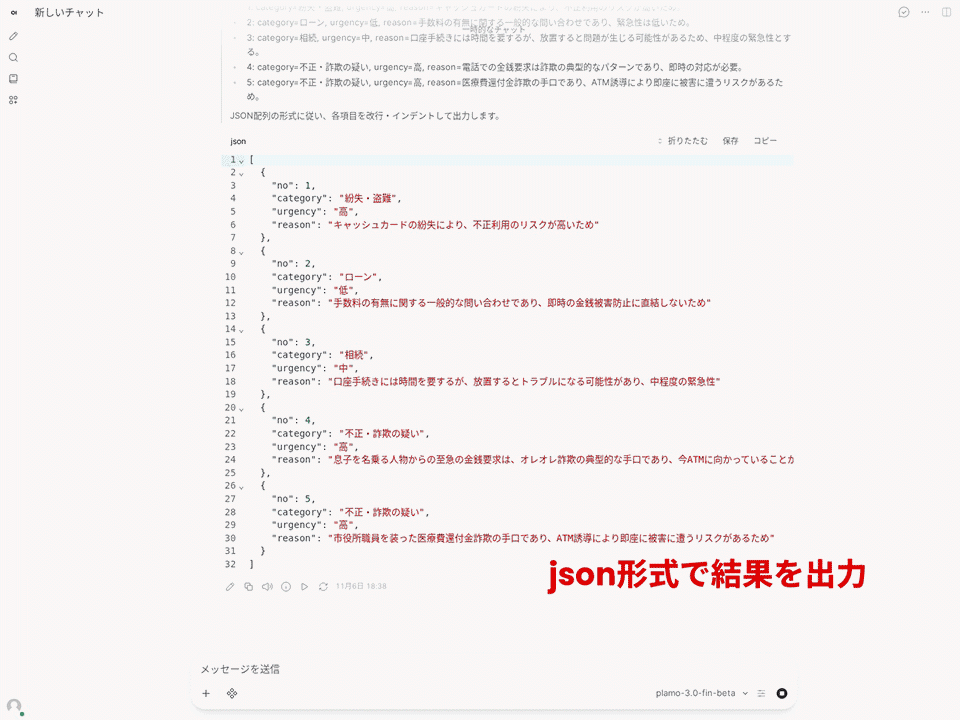
- 集成了分步骤推理功能,推理过程以日语输出,便于用户核实回答依据。
- 新增调用外部工具的能力,包括最新信息的网页搜索、计算功能及内部数据库查询。
- 体积小巧,运行速度快,支持在云端闭域环境及本地环境中仅用单块GPU即可高效运行。
- 作为开源权重模型在Hugging Face发布,允许在PLaMo社区许可范围内用于企业内部业务及自有产品和服务的商业用途。
- 后续训练中的推理功能和工具调用指令跟随学习均在自研AI半导体MN-Core 2上完成,实现了从AI半导体到基础模型及行业专用模型的国产技术全链条开发。
利用自研AI半导体MN-Core 2进行后续训练
PLaMo 3.0 Fin的指令跟随学习在搭载MN-Core 2的Preferred Networks集团计算平台PFCP上完成。MN-Core 2专注于深度学习中的矩阵运算,设计时注重每瓦性能表现。为了让更多开发者充分发挥该硬件性能,同时降低程序移植的专业门槛和开发负担,Preferred Networks正在研发以编码代理为核心的新型程序移植方法。
此次PLaMo 3.0 Fin的开发采用了该方法,使得即使缺乏MN-Core 2深厚专业知识的开发者,也能在一周内完成包括多板分布式学习支持在内的指令跟随学习代码移植。
通过移植后的代码训练,充分发挥了MN-Core 2在矩阵运算上的优势,实现了与GPU训练环境相当的实用训练速度。该成果表明,MN-Core 2在短时间内实现代码移植与高效训练的双重目标,有望成为AI开发中与GPU并驾齐驱的新选择。