日本Liquid AI公司于10月13日发布了LFM2.5系列的推理模型「LFM2.5-24B-A2B」。该模型的开源权重版本已在Hugging Face平台以「LFM Open License v1.0」协议免费公开。用户基本可免费使用,且支持商业用途,但年营业额超过1000万美元的企业需获取商业许可。此外,Liquid AI还通过Liquid Console提供API服务,API费用为每百万令牌输入0.10美元,缓存输入0.05美元,输出1美元。
LFM2.5-24B-A2B是一款专为文本AI代理设计的推理模型,能够在笔记本电脑等设备上高速运行。模型总参数量为240亿,采用限制每个令牌激活参数数量的方式降低计算负载。其上下文长度扩展至131,072令牌,并通过扩展的内置分词器支持多步骤任务和工具调用。
该模型每个令牌激活参数约为20亿,模型卡显示为24.5亿。词汇量达到128,000,层数为40层。采用混合专家模型(MoE)结构,每个MoE模块包含64个专家,使用Top-4路由选择4个专家。结合短卷积和GQA技术,预训练数据规模约为33万亿令牌。该模型为推理专用,能在生成最终答案前输出思考过程。
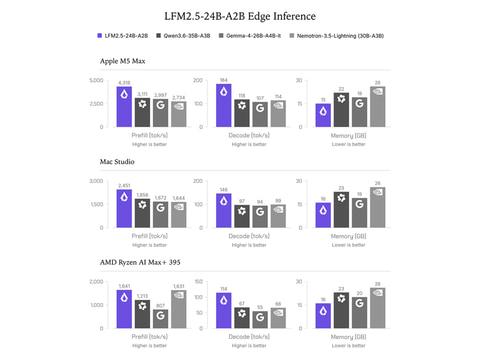
根据日本Liquid AI的测试,Apple M5 Max芯片上生成速度为184令牌/秒,输入处理速度为4,318令牌/秒,内存占用约15GB。Mac Studio的对应数据为146令牌/秒、2,451令牌/秒和16GB内存。AMD Ryzen AI Max+ 395的生成速度为114令牌/秒,输入速度为1,641令牌/秒,内存使用16GB。测试基于llama.cpp,采用Q4_K_M量化和4K令牌输入上下文长度。
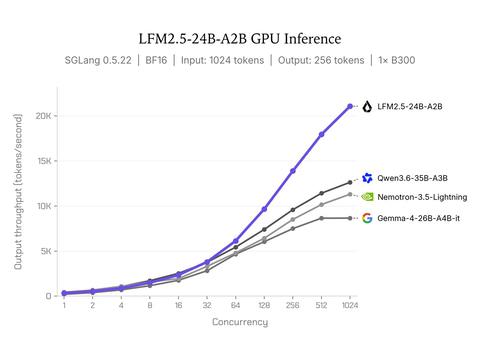
使用NVIDIA B300单卡进行GPU推理时,最大输出吞吐量达到21,070令牌/秒。此数据为多请求并行处理的总和,单请求生成速度有所不同。测试环境为SGLang 0.5.22,采用BF16精度,输入长度1024令牌,最大输出256令牌。
推理环境支持llama.cpp的GGUF格式、Apple Silicon的MLX、vLLM、SGLang、ONNX等多种平台。模型还计划与OpenClaw、Hermes Agent、Pi、OpenCode等AI代理执行环境集成,方便用户在本地硬件上进行推理和工具调用。