ElevenLabs致力于打造AI语音层,即将文本转化为听起来像真人的语音模型。大多数人接触到这项技术时,往往是在与客服交流时却未意识到。例如,Klarna利用该技术为3500万美国客户提供一线电话支持,德国电信、思科、Adobe及越来越多的政府机构也在使用。ElevenLabs还面向创作者销售平台,应用于有声书、配音和音乐制作。
ElevenLabs并非市场上唯一的玩家,实际上它正越来越多地与客户产生竞争关系,包括对话式AI平台Decagon,该平台曾基于ElevenLabs训练其语音产品,现在也推出了自有模型进行竞争。但投资者对此并不担忧。该公司表示,年经常性收入已达6亿美元,尽管成立仅四年,投资方估值已高达220亿美元。
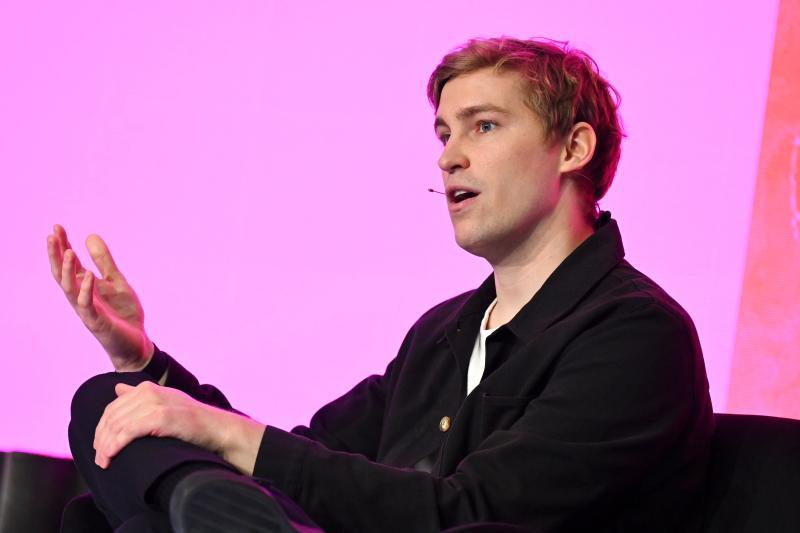
为了深入了解,我在多伦多本地创业大会Nrth(前称Elevate)采访了ElevenLabs联合创始人兼CEO Mati Staniszewski。我们讨论了多个话题,包括企业是否应告知客户他们正在与AI交流(他认为应该),以及公司毛利率情况。虽然他未透露具体数据,但明确表示如果能扩大市场份额,即使毛利率被进一步压缩也无妨。
以下为采访内容的精简版,全文可在相关平台观看。
去年你在TechCrunch Disrupt上曾预测音频模型将在几年内被商品化,你现在如何评价这一预测?
还有很多工作要做,单从模型层面提升质量的空间依然很大。长远来看,三到五年后这些差异会缩小。我们希望成为首个通过图灵测试的对话式AI,这不仅需要智能,还需要情感智能,能够理解对方情绪,适时调整语速,这一点尚未实现。
目前企业客户占比多少?
我们年经常性收入为6亿美元,超过55%来自传统企业,剩余45%中大部分是中小企业、开发者和创作者。
你们正与客户竞争,比如Decagon曾用你们的模型训练语音产品,现在用自家模型处理查询。
界限变得模糊。过去模型公司、平台公司、应用公司的界限很清晰,现在越来越模糊。以Anthropic为例,原本是模型公司,现在是平台且拥有多样化应用,这种趋势会持续。
客户可以从ElevenLabs的菜单中选择“推理层”,你们观察到前沿实验室模型和开源模型的使用情况如何?
这不是简单的二选一。若只是信息查询且无操作执行,开源模型足够,因为知识库定义了体验标准。但金融服务等场景需要身份验证、交易信息,容错空间极小,前沿模型仍占优势。
部分开源模型来自中国,而美国和欧洲政府是你们客户,这种情况如何处理?
视具体部署而定。不同国家有不同要求,可能用开源模型、闭源模型或自有微调模型。比如波兰医疗场景,患者预约后18%未到,系统会自动提醒,模型基于本地知识优化,且保证数据驻留。
企业是否应告知客户他们在与机器人而非真人交流?
我认为现在应当告知。人们尚未习惯,且不想感到被欺骗。但五年后,每个人都有自己的代理人,打电话时会期待与代理交流,届时社会观念会改变。可以通过提供选择,比如等待真人需30分钟,客户可选择机器人,绝大多数会选机器人并惊讶于体验质量。
考虑到模型和推理成本,你们的毛利率如何?
回答较模糊。我们通过研究优化模型,能智能地微调和限制模型。如果能节省成本会转嫁给客户。最重要的是证明价值并陪伴客户成长,因此愿意牺牲部分毛利率,共同分享未来五年创造的价值。
你们拥有数百万小时的客服通话录音,会用来训练模型吗?合成数据占比多少?
部分客户与我们共同打造专属模型。训练重点不在于数据量,而是数据标注。我们有数千名合同标注员,不仅标注内容,还标注说话时间、方式和情绪,甚至请语音教练帮助准确识别口音。
据报道你们计划2028年上市,能确认吗?
我们希望打造经得起时间考验的公司,正为未来几年上市打基础,但具体时间视情况而定。
“几年”说法很模糊。
(笑)
你怎么看前沿实验室是否应放缓发展?
大家都同意应协作寻找节奏。是否公开、媒体和监管介入程度另当别论。但我们应采取适当预防措施。我们不训练文本模型和智能核心,这是争论焦点。
ElevenLabs会像Hugging Face那样面临风险吗?
我们更进一步,不部署自我复制或递归智能部分。技术不允许代理生成更多代理。所有客户均通过身份验证。网络安全风险存在,但我们有完善防护措施。