我们虽然迟到了,但总比不来好。过去一段时间我们忙于筹备即将在一个月后举行的第二届AIE NYC大会,届时将有来自Bridgewater、Ramp、Coatue、Mastercard、Vanguard、Coinbase、Blackrock、Fidelity、Point72、Capital One、JPMC、Wells Fargo、Bloomberg、A24电影制片厂、Two Sigma、Apollo Global等多家机构的嘉宾参与,门票价格即将上涨,欢迎提前购票!
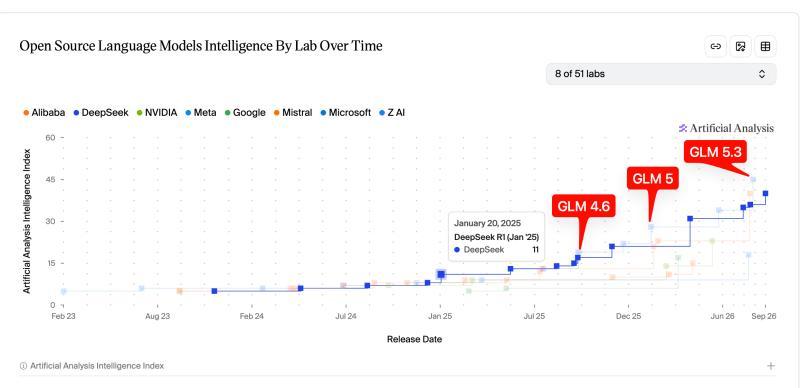
DeepSeek的研究策略令人着迷。在重大版本更新之间,如从v2到v3再到v4,他们不断发布聚焦于架构改进的中间论文,命中率几乎100%,涵盖数学(特别是GRPO)、编码器、R1模型,以及最近关于流形约束超连接和压缩稀疏注意力的研究。继2025年上半年R1论文引发巨大关注后,DeepSeek曾一度低调,过去一年更是让GLM和Kimi等同行在开放模型领域领跑。
尽管一度前景不明朗,但真正的鲸鱼玩家始终坚定不移。如今,DeepSeek带来了全新架构,宣布软退役V4 Pro,全面投入这款新模型——V4.1 Flash。尽管命名仅为v4.1,但其技术进步远超0.1的升级幅度,甚至首次将视觉能力整合进模型,无需等待独立版本。
V4.1 Flash在部分基准测试中落后于其他开源模型,原因在于现有基准尚无法准确衡量其创新目标——即前所未有的上下文利用效率和创造力。若只看版本号和基准排名,容易被表象迷惑,真正的进步需要深入理解其架构设计。
Sebastian Raschka称其为“大规模改造”,甚至认为应命名为DeepSeek V5,强调编码器-解码器结构是与以往DeepSeek模型的关键区别。该模型采用7630亿参数规模,8亿激活输入参数和16亿激活输出参数,支持百万级上下文长度,具备文本与图像多模态输入,采用MIT开源许可,并通过DeepSeek官方API在美国提供服务。
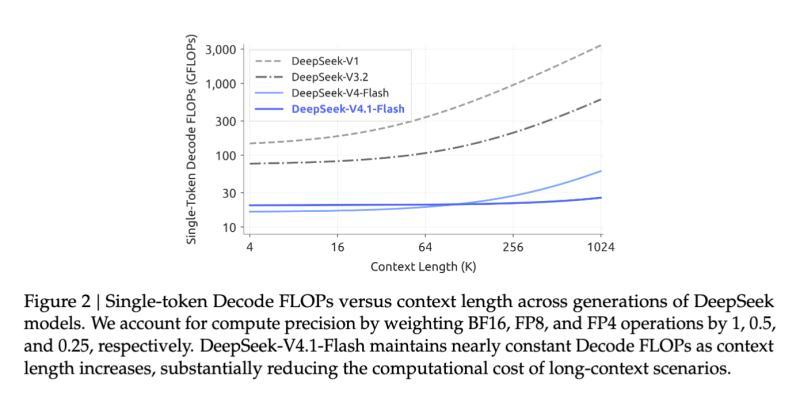
技术细节方面,V4.1 Flash引入了滑动窗口注意力边界重放机制,使KV缓存占用仅为V4 Flash的1/8,极大提升了长时间运行智能体的效率和成本表现。模型架构融合了局部滑动窗口分支与稀疏检索分支,形成稀疏与局部混合的新范式。视觉前端采用3x3像素反卷积处理,区别于常见的2x2方案,且在首层采用了仅滑动窗口注意力的设计,反映出训练早期层的挑战。
独立评测显示,V4.1 Flash在成本调整后的智能水平、长上下文处理和自动化能力方面表现突出。Artificial Analysis给出40分的智能指数,自动化基准得分69%,超过GPT-6 Astra和Grok 4.6,且推理成本极低,仅约0.27美元每任务,远低于GLM-5.3和Kimi K3。尽管模型生成内容较为冗长,但其极低的令牌成本使整体性价比极高。
本地部署方面,用户报告在配备4张Max-Q GPU和64GB系统内存的设备上,通过NVMe SSD卸载200GB Engram哈希表,实现200次每秒的推理速度,后续优化至300+ TPS,且内存占用低于32GB。SSD流式加载技术使得在128GB内存的M5 Max设备上运行也十分流畅,极大降低了本地运行门槛。
DeepSeek V4.1 Flash的发布正值行业从“大型密集聊天模型”向“系统优化、稀疏、长上下文、面向智能体的模型”转变的关键时期。其开放权重、MIT许可、百万上下文、多模态输入、低激活参数和极致缓存压缩的组合,展示了未来模型在可服务性和成本效益上的新方向。
此外,OpenAI发布了GPT-Live-1全双工语音接口API,支持边听边说,配合工具调用和推理,推动语音智能体生态快速发展。企业数据访问也成为产品重点,ChatGPT Work推出数据智能体,支持企业数据的仪表盘、问答和操作。
Cognition发布了SWE-2编码模型,声称在主流编码评测中以低70%成本达到前沿水平,并推出了多模态集成的Devin Voice。Cursor引入了持久化项目线程和协调智能体,推动编码智能体向持久上下文和多设备同步发展。
在智能体研究领域,训练弱模型以模仿强模型轨迹可能导致性能下降,需针对失败步骤进行局部改写以保持模型与训练环境匹配。长时域和长上下文训练技术也在进步,如弹性轨迹长度控制和并行子智能体架构显著提升效率。
安全方面,Anthropic发布了迄今最详尽的滥用报告,涵盖网络攻击、影响操作、生物学、监控和武器领域的尝试,强调了透明度的重要性。社区对模型推理可监控性和“神经语言”风险展开讨论,呼吁发布相关证据和政策。
总的来看,DeepSeek V4.1 Flash不仅是一次技术上的重大突破,也代表了开放模型在实用性、成本和多模态能力上的新高度。它的发布引发了业界广泛关注和热烈讨论,成为2026年AI模型发展的重要里程碑。