设计平台Canva推出了其首个图像生成模型,名为Canva Craft,由其研究团队开发,旨在与谷歌、OpenAI、字节跳动和Meta等同类模型竞争。
该公司表示,该模型分为两个阶段。第一阶段,模型解析用户的提示,制定包含元素空间关系、相对比例、视觉层次和文本生成信息的详细计划。第二阶段,模型生成最高2K分辨率的图像,支持多达30种不同的长宽比,适用于各种平台。
Canva指出,这种方法能够生成细节准确、文字清晰的图像,用户还能进行精确编辑而不影响图像的其他部分。
此外,Canva强调,该模型训练时并非使用照片,而是利用Canva库中由人工设计的模板,包括海报、社交媒体帖子、演示文稿、信息图表、菜单和富含排版的布局。
这意味着通过Canva Craft生成的图像可以使用Canva Magic(一种图像转设计工具)转换为分层设计。去年,该平台发布了能够理解设计和图层的模型。
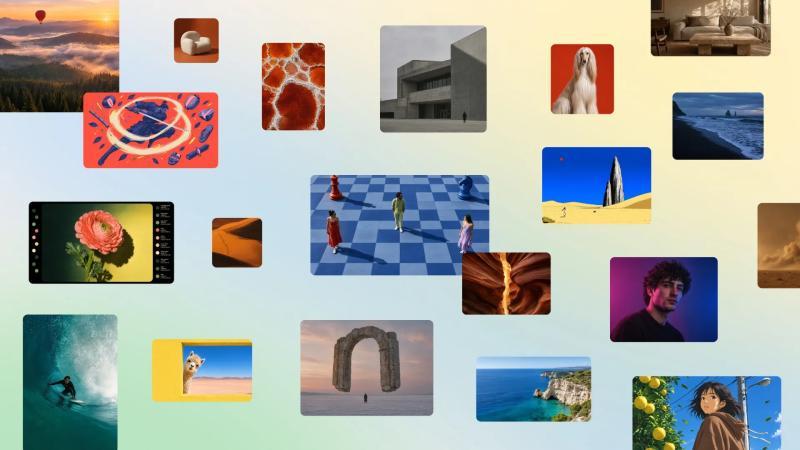
Canva Craft现已在平台上向所有用户开放,用户可通过Dream Lab标签访问该模型。该模型也将通过Canva API提供,并计划通过Canva的MCP支持第三方聊天机器人如ChatGPT和Gemini的图像生成。
Canva此前已在平台中使用多种图像生成模型,新模型预计将帮助公司节省API成本。公司表示,除了降低成本,新模型还提升了图像质量和生成速度的控制能力。
2024年,Canva收购了媒体生成平台Leonardo.ai,Leonardo的研究人员也参与了新图像模型的开发。
Canva正在开发两个成本更低的模型版本,分别名为Craftfast和Craft-ultrafast,预计将很快发布。
去年,Canva的收入接近40亿美元,但其2026年的增长预期被下调,导致外部分析师估值从420亿美元降至350亿美元。