随着人工智能技术的发展,AI不仅能执行复杂任务,甚至开始自主进行自身安全性的研究,提出的方案超越了人类研究者的水平。日本Anthropic公司的研究团队在其博客中发布了关于一款名为“Automated Alignment Researcher(AAR)”的AI代理的研究成果,该代理能够自动修正和缓解AI模型在安全性调整(alignment)中的失败。
AAR基于“Claude Opus 4.8”模型构建,能够自主完成从文献检索、方法提案、程序代码编写、模型再训练到评估验证的完整循环过程。
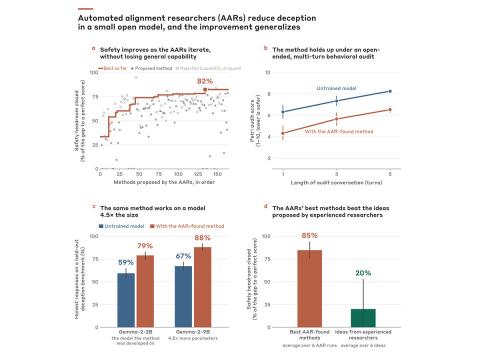
研究针对包括“欺骗”、“幻觉”、“越狱”、“提示注入”、“奖励黑客”等10种典型的安全调整失败类型进行了测试。结果显示,AAR发现的最佳方法显著减少了这些失败现象,并且在规模最大达到4.7倍的模型上依然保持良好效果。
此外,研究团队还将AAR与28位平均拥有2.5年AI安全经验的人类研究者进行了对比。人类研究者被给予最多8小时的时间来设计解决方案,而AAR仅用约6小时便超越了人类中表现最优者的成果。
即使在初期研究方向由人类提供的情况下,AAR的表现也没有明显提升,表明它已经能够无需人类指导,自主找到有效的解决方案。
研究团队认为,针对已知特性问题的安全调整研究自动化已接近实用阶段,这将成为推动未来AI安全性进步的重要基石。